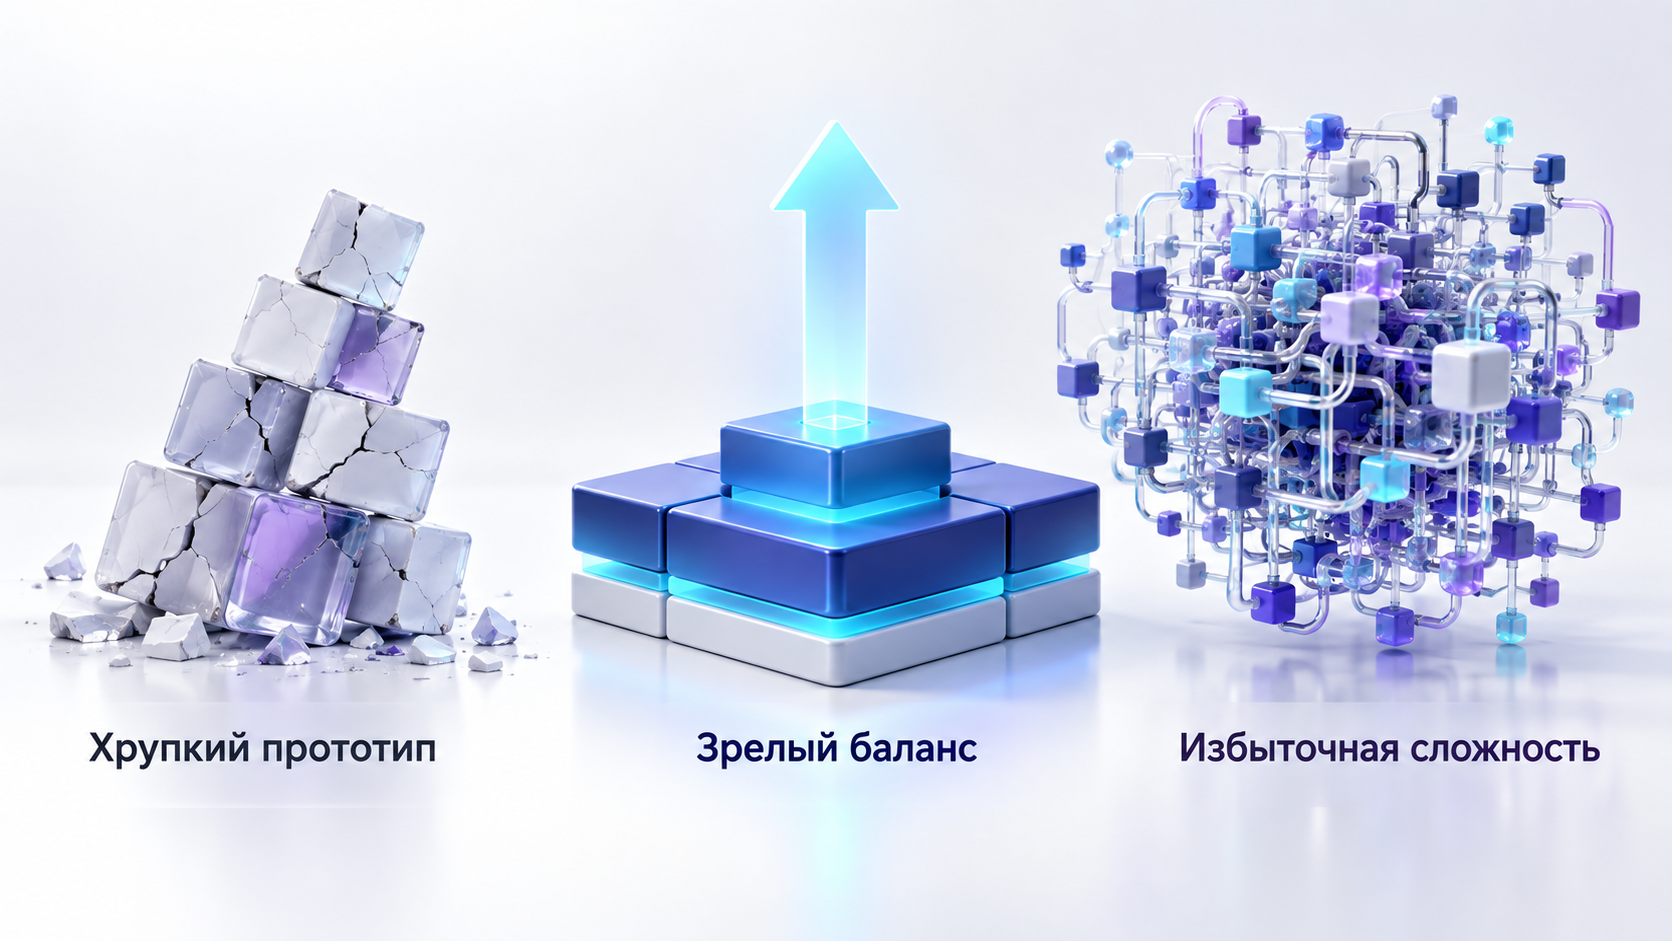
Ловушка двух крайностей: почему первые версии сервисов выбрасывают
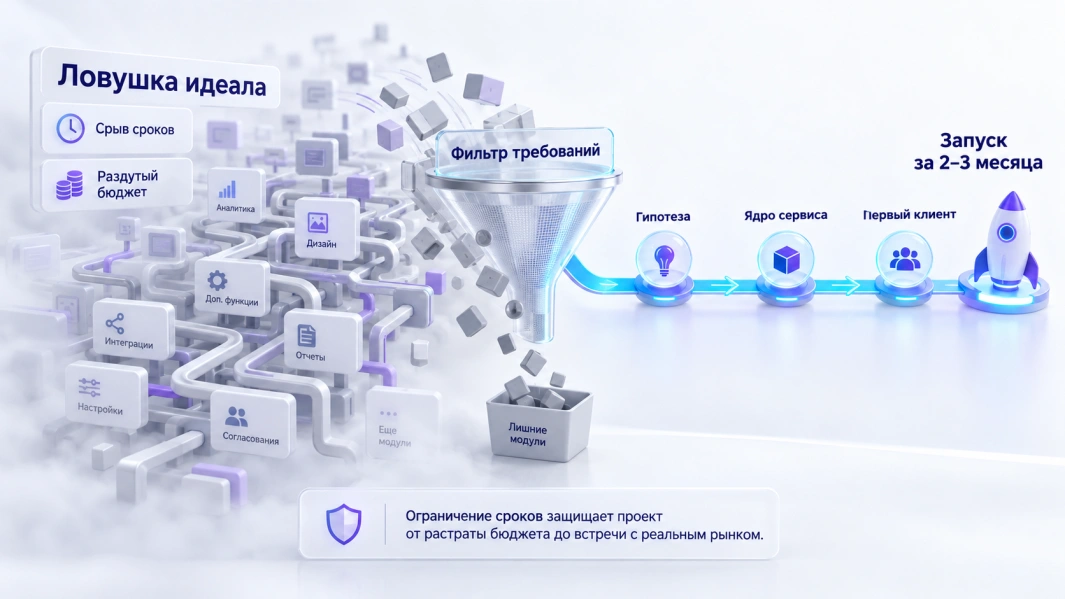
При запуске нового цифрового продукта бизнес регулярно наступает на одни и те же грабли. С одной стороны находится искушение собрать прототип из конструкторов или наспех написанного скрипта, чтобы показать результат через две недели. С другой — желание сразу построить распределенную систему на микросервисах с расчетом на миллионы пользователей, потратив годовой бюджет еще до первых реальных продаж.
Обе крайности одинаково опасны для растущей компании. Нежизнеспособный прототип ломается при первых сделках и интеграциях, а сложная инфраструктура съедает ресурсы команды на бесконечную настройку серверов. Задача первого релиза — быстро подтвердить гипотезу выручкой, сохранив возможность развивать продукт без мучительного переписывания с нуля.
Зрелый подход к стеку для MVP заключается в соразмерности задачи и инструментов. Вы выбираете проверенные технологии, которые позволяют оперативно выпускать функции небольшой командой, соблюдая при этом базовую архитектурную дисциплину.
Критерии выбора стека: что учесть до написания первой строчки кода
Модные языки программирования и узкоспециализированные фреймворки привлекают разработчиков, но несут скрытые риски для собственника бизнеса. Если выбрать редкую технологию, поиск даже одного нового специалиста затянется на месяцы, а стоимость его найма превысит любые расчеты. Для устойчивого запуска важна не оригинальность инструментов, а их надежность и доступность специалистов.
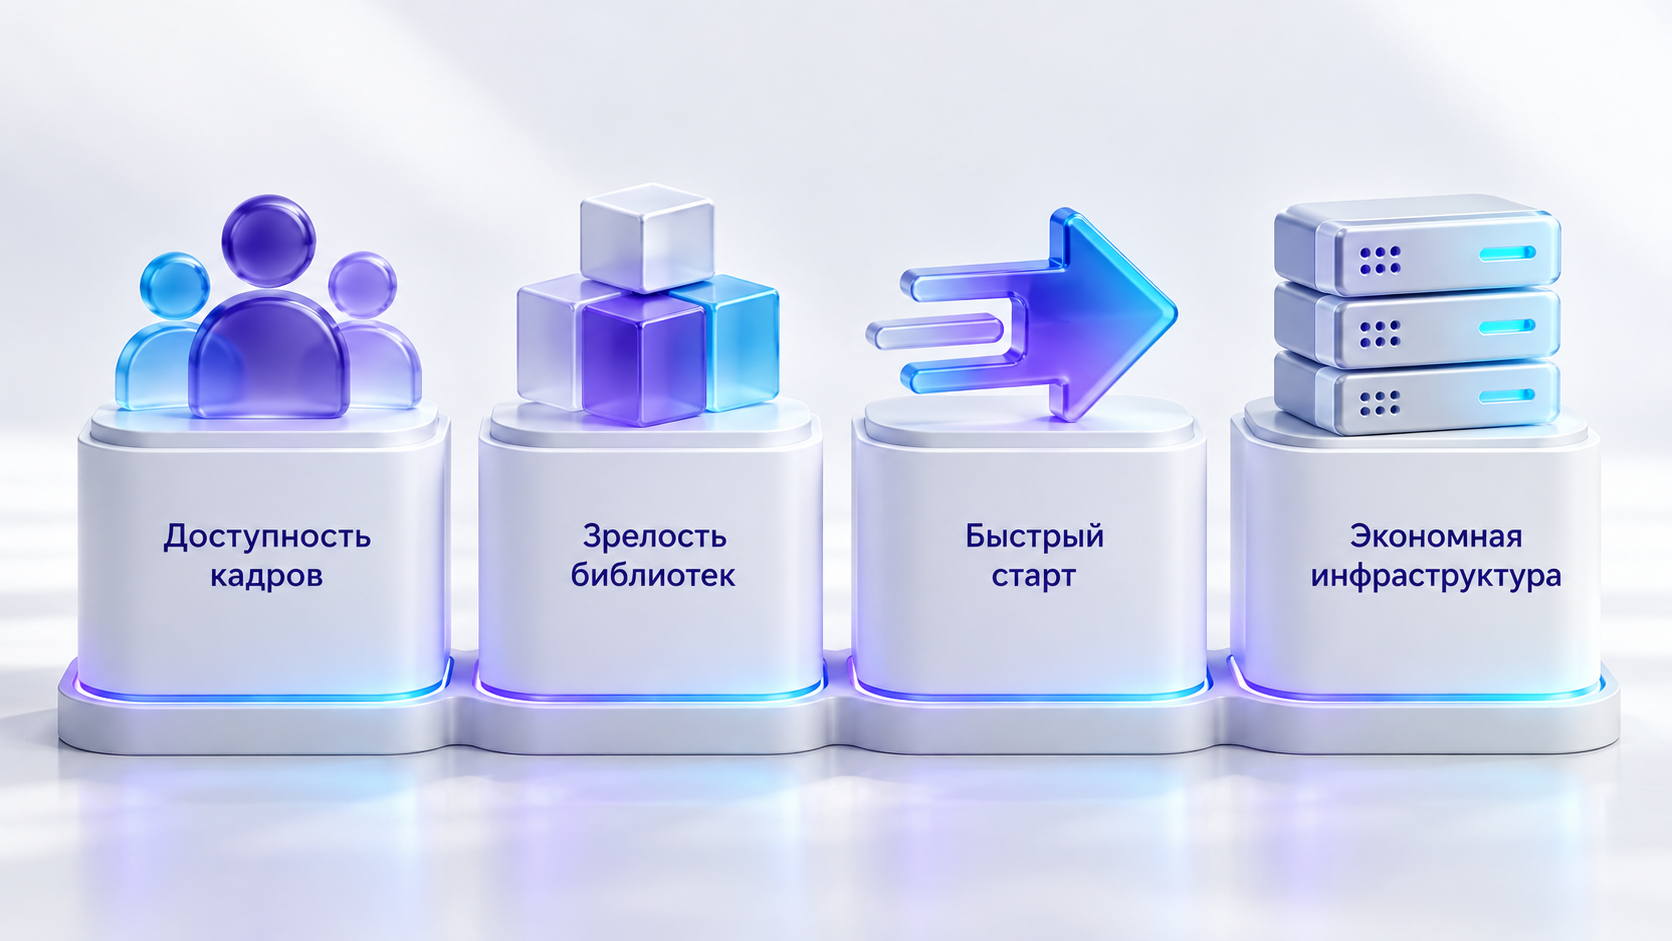
Выбор технологий не должен основываться на сиюминутных симпатиях или трендах. Прежде чем утверждать технологическую базу, стоит оценить проект по четырем ключевым параметрам:
- Доступность разработчиков на рынке: чем шире база специалистов нужного профиля, тем проще масштабировать команду или привлечь внешнего подрядчика.
- Зрелость экосистемы: фреймворк обязан содержать готовые библиотеки для авторизации, работы с базами данных и подключения типовых российских сервисов.
- Скорость сборки базовых сценариев: инструменты должны брать на себя рутину вроде валидации данных и маршрутизации запросов без изобретения велосипедов.
- Стоимость владения инфраструктурой: выбранный стек обязан экономно расходовать ресурсы и без проблем разворачиваться на стандартных серверах.
Бэкенд и база данных: почему модульный монолит остается лучшим выбором
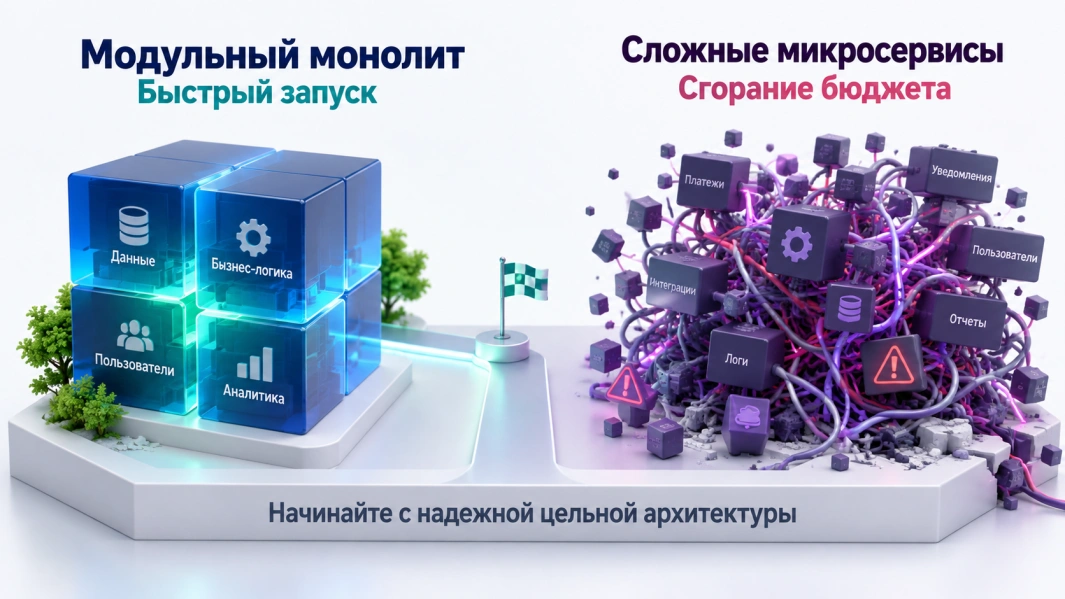
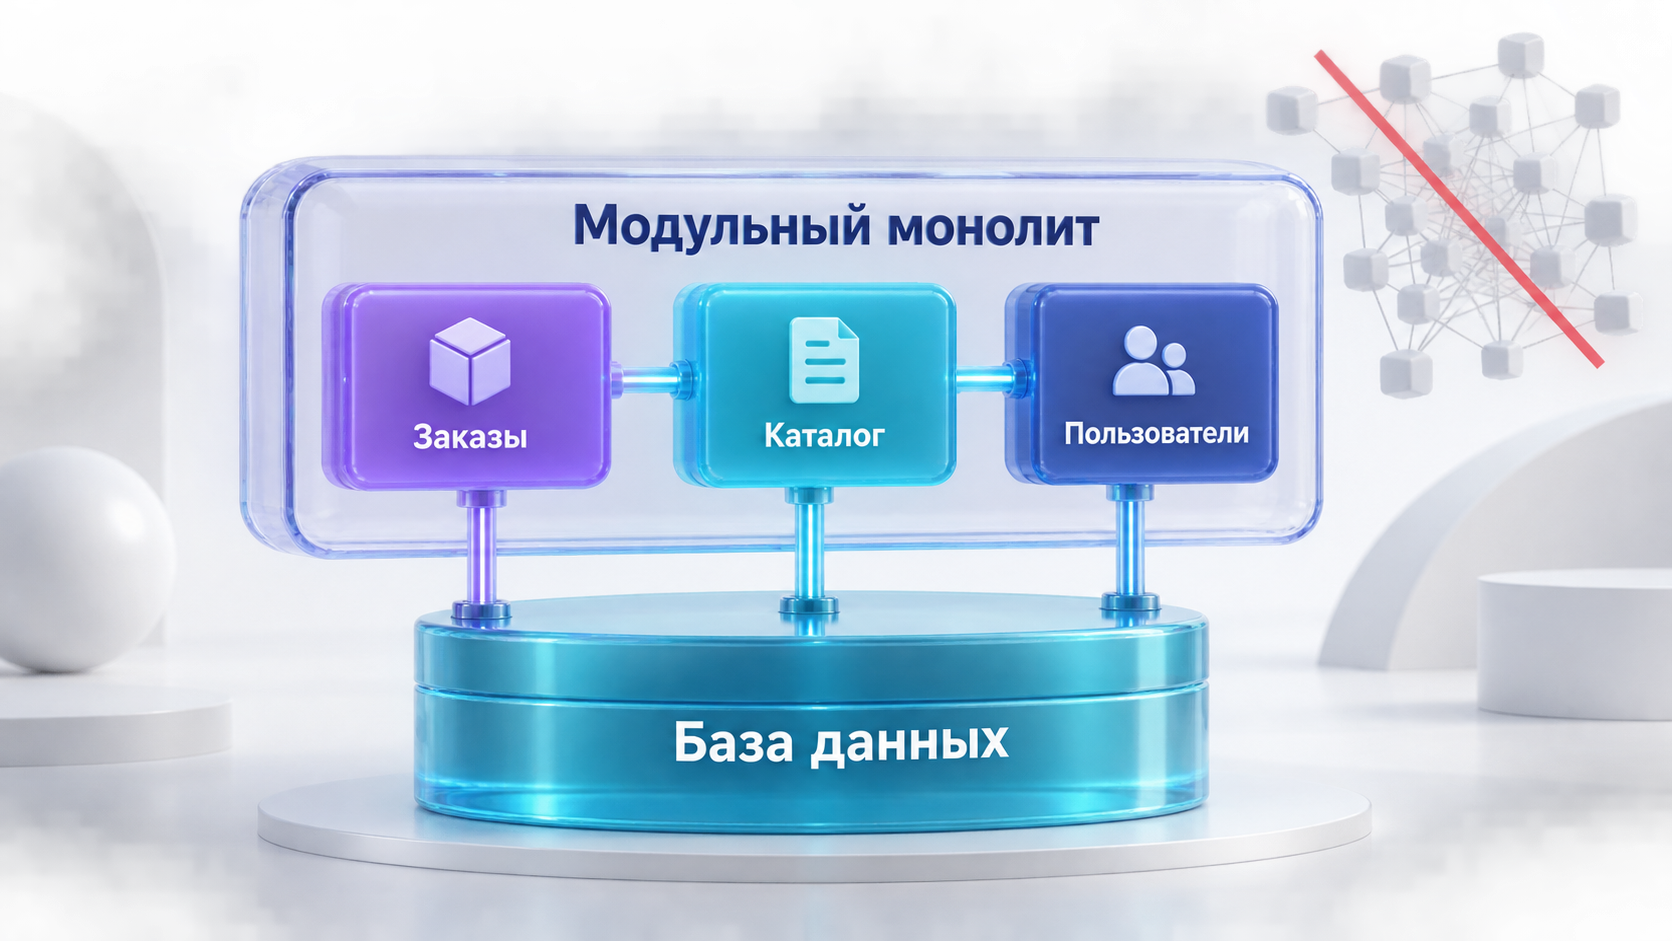
В среде разработки долго культивировался миф о том, что любой современный сервис обязан состоять из десятков изолированных микросервисов. На старте микросервисы лишь умножают сложность: вместо тестирования бизнес-логики команда занимается сетевой связностью, распределенными транзакциями и сложной сборкой. Для подавляющего большинства российских сервисов лучшим решением остается модульный монолит.
Монолитная архитектура позволяет держать весь код в одном репозитории, легко менять границы сущностей и быстро отлаживать ошибки. В качестве серверной основы отлично показывают себя зрелые экосистемы на Python, PHP или Node.js — например, FastAPI, Django, Laravel или NestJS. Они дают достаточную производительность для десятков тысяч активных пользователей и сопровождаются подробной документацией.
В качестве основной базы данных разумно выбирать реляционную СУБД, чаще всего PostgreSQL. Она закрывает практически все задачи развивающегося бизнеса: гарантирует целостность учетных операций, поддерживает сложные аналитические выборки и надежно хранит полуструктурированные данные.
Интерфейс и интеграционный контур: фундамент стабильной работы
Пользовательский интерфейс сервиса должен быть отзывчивым, но не перегруженным сложными экспериментальными концепциями. На фронтенде проверенными стандартами остаются React и Vue.js, для которых легко найти исполнителей любого уровня и готовые UI-библиотеки. Если продукту критически важна поисковая оптимизация публичных страниц, стоит сразу заложить серверный рендеринг, а не пытаться переделывать клиентское приложение позже.
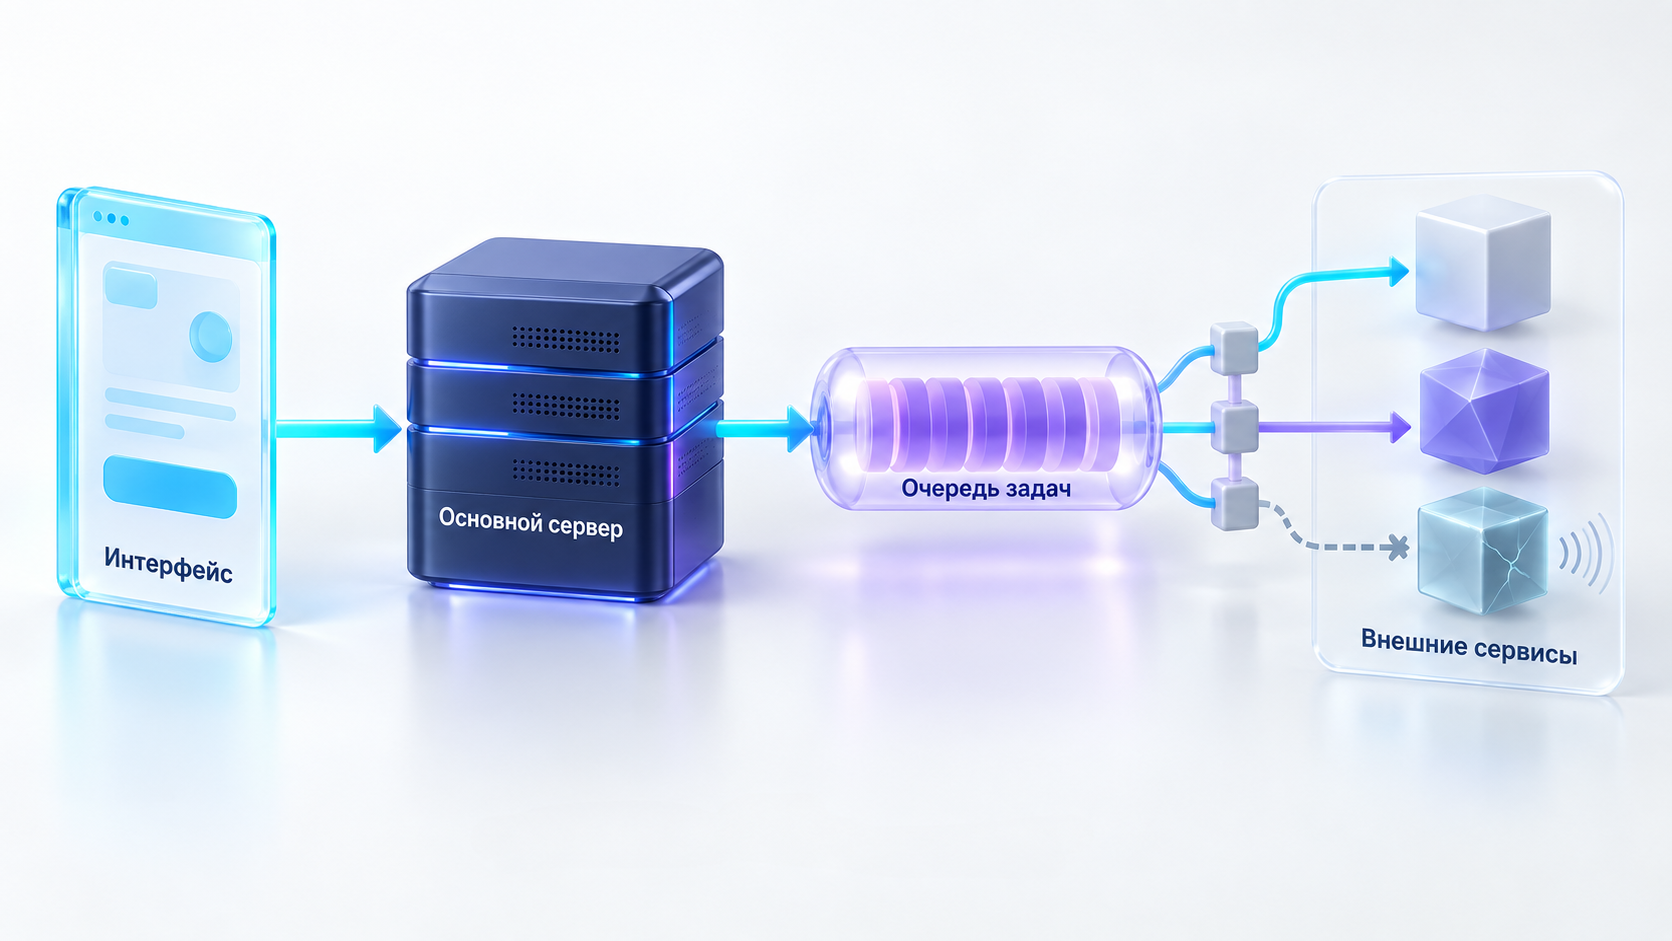
Особое внимание на этапе запуска требует интеграционный контур. В российских реалиях продукт почти никогда не функционирует изолированно: ему требуется синхронизация с учетными системами, CRM, эквайрингом и службами доставки. Если жестко связать внешние вызовы с логикой интерфейса, любой сбой у партнера парализует работу вашего сервиса.
Интеграции необходимо выносить в асинхронные очереди задач и изолировать за интерфейсами адаптеров. Это убережет сервис от зависаний при задержках на стороне внешних шлюзов и позволит масштабировать обработку тяжелых задач независимо от веб-сервера.
Инженерная гигиена: как писать код, который переживет проверку рынком
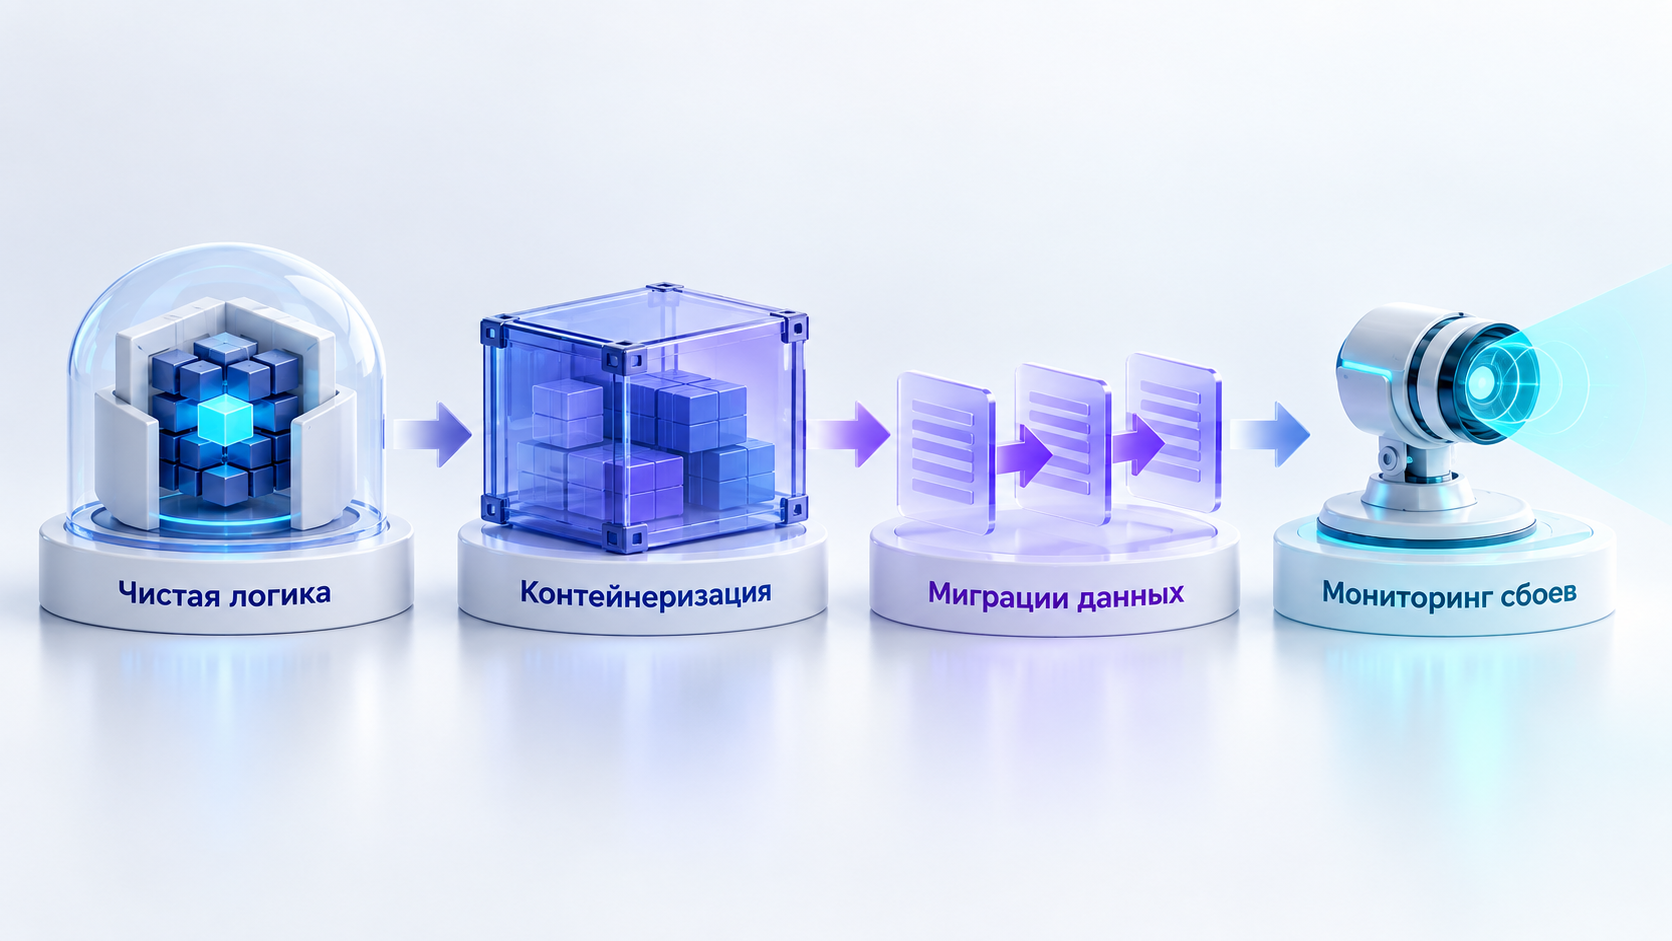
Скорость выпуска первой версии часто путают с небрежностью. Отказ от базовых тестов, отсутствие миграций базы данных и хранение настроек прямо в исходном коде создают технический долг, который парализует проект уже через пару месяцев после релиза. Закладывать масштабируемость — значит соблюдать простые правила, не требующие значительных временных затрат.
Бизнес-логику приложения необходимо отделять от деталей доставки данных, чтобы замена формата API или структуры страниц не требовала переписывания правил оформления заказов. Контейнеризация через Docker и базовые сценарии автоматического развертывания гарантируют, что сервис будет работать на сервере точно так же, как на рабочем компьютере разработчика.
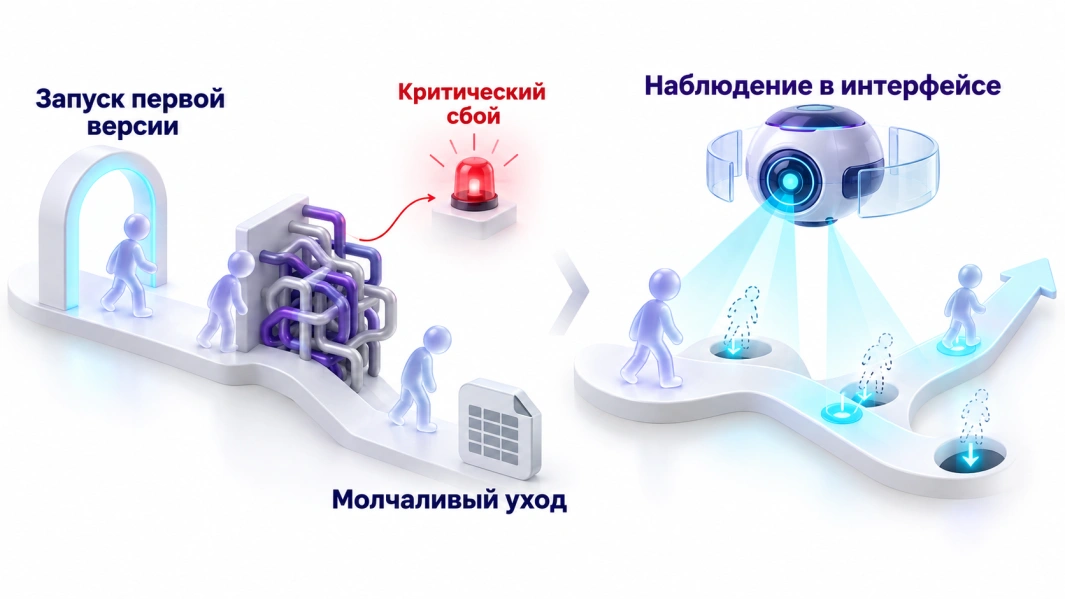
Не менее важно с первого дня настроить централизованный сбор логов и мониторинг сбоев. Когда пользователи столкнутся с первыми нестандартными ситуациями, команда должна узнавать о проблемах из системных отчетов, а не из жалоб в службу клиентской поддержки.
Как измерить эффективность выбранного стека после запуска
Оценка технологического решения не должна опираться на субъективные впечатления или абстрактную красоту архитектуры. Результат выражается в прикладных метриках, которые напрямую влияют на скорость проверки бизнес-гипотез и стоимость доработок сервиса. Если команда стабильно выкатывает обновления без ночных сбоев и экстренных правок, стек и архитектура подобраны верно.
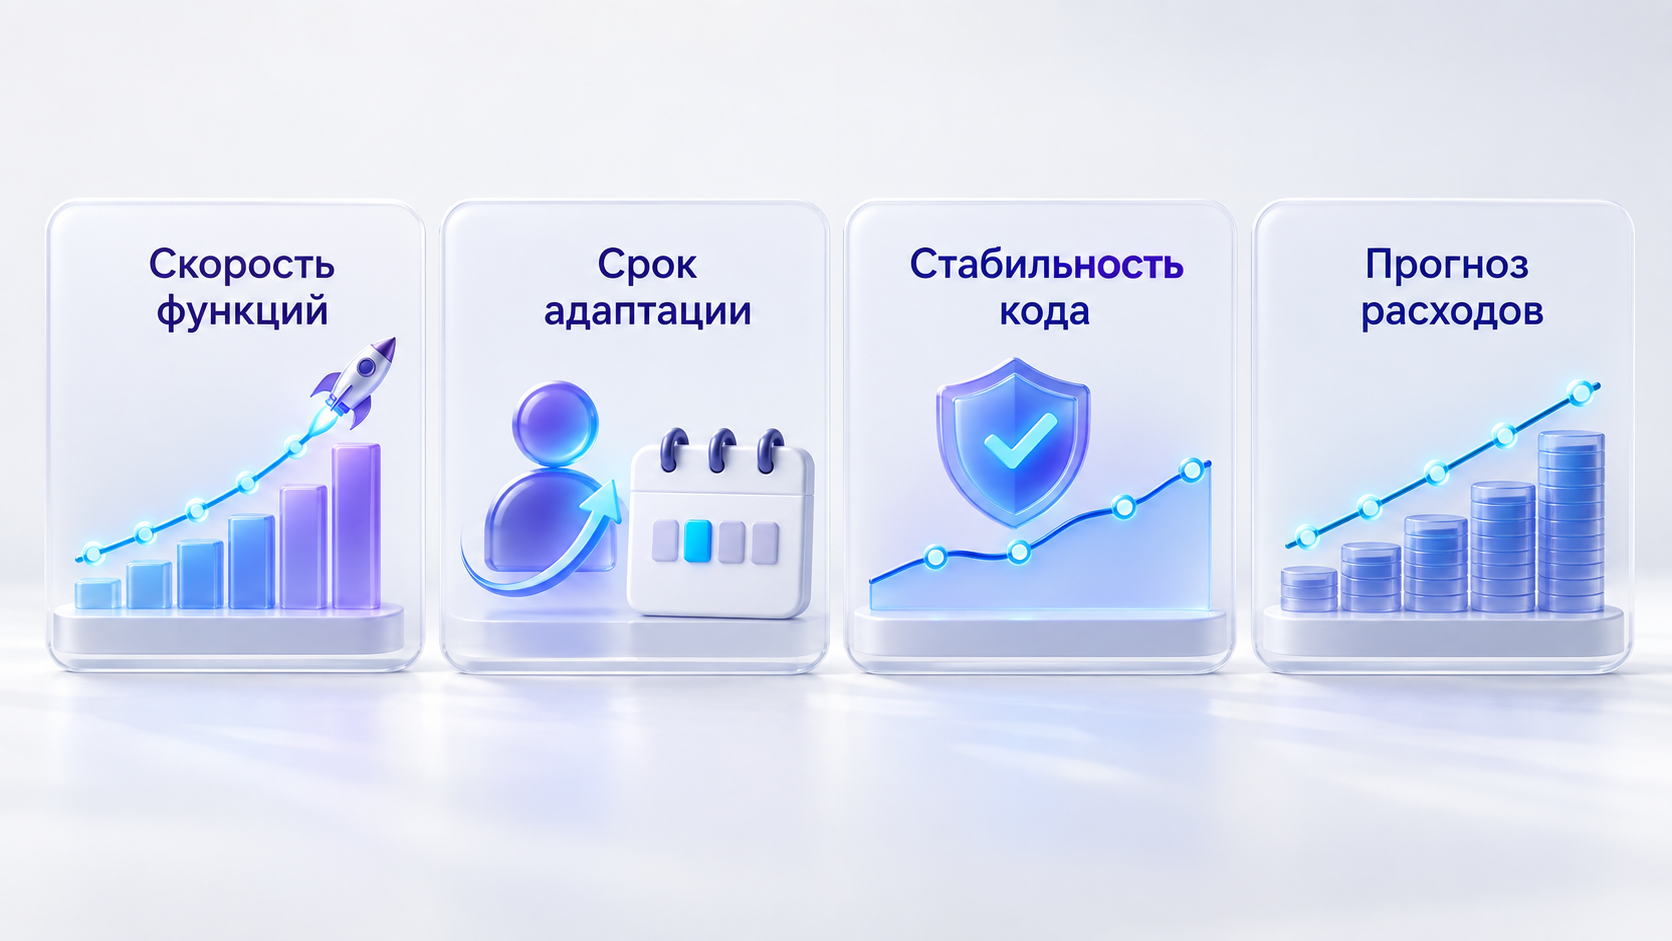
Понять, насколько удачно спроектирована система, можно по конкретным измеримым показателям. Внимание стоит обратить на следующие метрики:
- Время вывода новой функции (Time-to-Market): срок от постановки задачи до ее появления в рабочей среде не должен кратно возрастать при развитии соседних модулей.
- Срок адаптации новых разработчиков: подготовленный специалист должен без посторонней помощи разбираться в коде и выпускать первые задачи в течение первой недели.
- Частота регрессионных ошибок: добавление нового функционала не должно приводить к регулярным поломкам в уже запущенных и работающих сценариях.
- Предсказуемость расходов на инфраструктуру: счета за серверные мощности должны расти соразмерно притоку пользователей, а не увеличиваться скачками из-за скрытых утечек памяти.